RAGとは、AIが回答前に自社資料を「検索」し、その内容をもとに「生成」する仕組みです。汎用AIを自社業務に詳しい専用AIに変えられます。仕組み・始め方・情報漏洩対策まで非エンジニア向けに解説します。
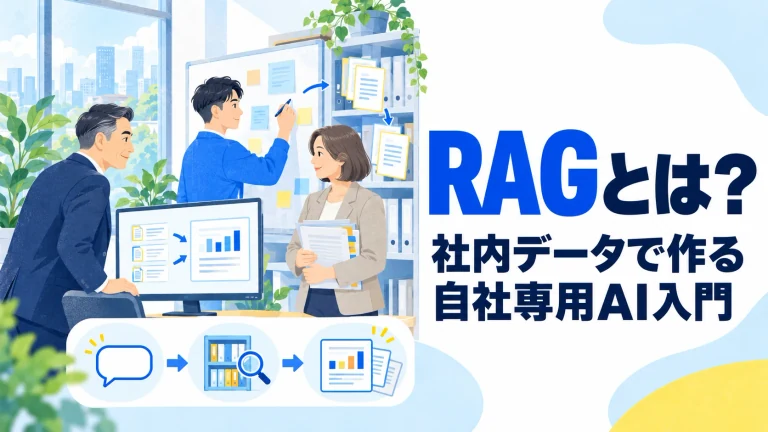
RAG(検索拡張生成、Retrieval-Augmented Generation)とは、AIが回答する前に自社のマニュアルや資料を「検索」し、その内容をもとに答えを「生成」する仕組みです。これにより、ChatGPTやClaudeのような汎用のAIを、自社の業務に詳しい「自社専用AI」に近づけることができます。
本記事では、RAGの仕組みを「探す→渡す→答える」の3ステップで解説し、AIに直接覚えさせる方法との違い、中小企業が小さく始める方法、精度を上げるコツ、そして最も大事な情報漏洩と著作権の注意点までを整理します。
1. なぜRAGが必要なのか
汎用のAIは、インターネット上の膨大な文章を学習していますが、「あなたの会社の社内ルール・商品の仕様・過去の議事録」は知りません。学習していない情報には正確に答えられず、ときに事実でない内容をもっともらしく作り出してしまうこともあります(ハルシネーション)。
RAGは、回答の根拠となる自社の資料をその場でAIに渡すことで、この弱点を補います。「覚えていないことを、手元の資料を見ながら答えてもらう」仕組みだと考えると分かりやすいでしょう。試験にたとえるなら、暗記で答えるのではなく、教科書の持ち込みを許可するようなものです。
2. RAGの仕組み:3ステップで理解する
RAGは「探す→渡す→答える」の3ステップで動きます。専門知識がなくても、この流れさえ押さえれば十分です。
ステップ1:質問に関係する資料を「探す」
利用者が質問すると、まず自社の資料の中から、質問に関連しそうな部分を検索します。たとえば「有給休暇は何日前に申請するの?」と聞けば、就業規則の該当箇所を探し出します。
ステップ2:見つけた資料をAIに「渡す」
検索で見つかった部分を、AIへの指示文に添えて渡します。AIは「この資料を参考に答えてください」という形で受け取ります。
ステップ3:資料をもとに「答える」
AIは渡された資料を読み、それをもとに自然な文章で回答します。手元に根拠があるため、推測ではなく自社の実態に沿った答えになりやすいのが特徴です。「どの資料のどこを見たか」を回答に添えさせることもできます。
「探す」の裏側:言葉ではなく「意味」で探す
RAGの検索は、キーワードが一致するかどうかだけでなく、「意味が近いかどうか」で資料を探すのが一般的です。資料の文章をあらかじめ「意味を表す数字の並び」に変換して保存しておき、質問も同じように変換して、意味の近いものを探します。そのため、「有休」と「年次有給休暇」のように言い回しが違っても、関連する箇所を見つけやすくなります。
3. RAGと「AIに直接覚えさせる方法」は何が違うのか
結論として、多くの中小企業にはRAGのほうが向いています。理由は、費用が低く、資料の更新が簡単だからです。AIに自社の情報を持たせる方法は、大きく2つあります。
比較項目 | RAG(資料を読ませる) | ファインチューニング(AI自体を追加学習) |
|---|---|---|
仕組み | その都度、資料を検索して渡す | AIのモデル自体に追加で学習させる |
情報の更新 | 資料を差し替えるだけ | 学習し直しが必要で手間がかかる |
費用 | 比較的低い | 高くなりやすい |
回答の根拠 | 「どの資料を見たか」を示しやすい | 根拠を示しにくい |
向いている場面 | 頻繁に更新される社内資料 | 独自の文体や専門的な作業の定着 |
就業規則やマニュアルは更新が多いため、差し替えるだけで済むRAGのほうが扱いやすいとされています。
長い資料を丸ごと読めるAIがあっても、RAGは必要?
最近のAIは、一度に読み込める文章量(コンテキストウィンドウ)が大きくなり、主要な上位モデルの多くは100万トークン前後の資料を一度に扱えるようになりました。資料が数本だけなら、丸ごと渡して質問するほうが手軽な場合もあります。
ただし、社内の資料が数百・数千件になると、毎回すべてを読ませるのは費用と時間がかかりすぎます。また、「この人には見せてよい資料だけを探す」といった権限の管理も、検索の段階で行うほうが確実です。資料の量が多い会社ほど、RAGの仕組みが役に立ちます。
4. 自社専用AIを作る価値:どんな業務に効くのか
RAGの価値は「社内に散らばった知識を、誰でもすぐ引き出せる状態にする」ことにあります。ベテランしか知らない情報や、探すのに時間がかかる資料が、質問するだけで返ってくるようになるからです。
- 社内ヘルプデスク:就業規則・経費精算・申請手続きへの問い合わせ対応
- 商品・サービス案内:仕様書や価格表をもとにした営業・カスタマーサポートの支援
- 新人教育:マニュアルや過去の事例をもとにした質問対応
- 議事録・報告書の検索:「あの件はどうなった?」を過去の資料から探す
AIが「文章を作る」段階から「業務を代行するAIエージェント」へと進化するなかで、RAGはその土台として、AIに正しい社内情報を与える役割を担います。
効果が出やすいのは、「同じ質問が何度も来る」「答えは資料に書いてあるのに、探すのに時間がかかる」業務です。たとえば総務の担当者が毎月何十件も受けている申請方法の質問にAIが一次回答できれば、担当者は例外的な相談だけに集中できます。質問する側も、担当者の手が空くのを待たずにすぐ答えが得られます。
5. 始め方:小さく試すのが成功のコツ
最初は「よく聞かれる質問が集中している資料」1つから始めるのがおすすめです。対象を絞ったほうが効果を確かめやすく、失敗したときの影響も小さいからです。
- 対象の資料を決める:就業規則、よくある質問集など、問い合わせが多いものを1つ選ぶ
- 資料を整える:古い版を削除し、最新版だけにそろえる(情報の鮮度が回答の精度を左右します)
- 道具を選ぶ:まずは既存のサービスで試し、効果が見えたら社内向けの仕組みづくりを検討する
- 試して調整する:実際に質問し、答えがずれる場合は資料の書き方や区切り方を見直す
開発をしなくても、RAGに近い使い方はすぐに試せます。ChatGPTやClaudeの「プロジェクト」機能、GoogleのNotebookLMのように、資料をアップロードしてから質問できるサービスがあるためです。まずはこうした機能で「資料をもとに答えてもらう」体験をし、社内での使い道を確かめるのが近道です。
試してみて「これは使える」と感じたら、次は全社に広げるかどうかを判断します。目安は、①回答が資料と合っている割合が十分に高いか、②資料の更新を続けられる担当者がいるか、③社外秘の資料を扱える契約・環境になっているか、の3点です。どれかが満たせないうちは、対象の資料や利用者を絞ったまま運用を続けるほうが安全です。
使うAIのモデルは、用途に応じて選べます。複雑な判断が必要な業務にはOpenAIのGPT-6 Astra、AnthropicのClaude Fable 5.1やOpus 5.5、GoogleのGemini 4 Argonといった上位のモデルが、シンプルな問い合わせ対応には高速・低価格なモデルが向いています。
6. 回答の精度を上げる資料づくりのコツ
RAGの答えの質は、AIの性能以上に「渡す資料の質」で決まります。次の点を意識するだけで、精度は大きく変わります。
- 1つの段落に1つの話題:複数の話題が混ざった長い段落は、検索で見つかりにくくなる
- 見出しを付ける:「経費精算の締め日」のように、何の話かが分かる見出しを付ける
- 表や画像の内容は文章でも書く:表や画像の中の情報は、読み取れない場合がある
- 「資料に無いことは答えない」と指示する:根拠が見つからないときは「分からない」と答えさせ、作り話を防ぐ
- 出典を示させる:回答に「どの資料のどこを見たか」を添えさせ、人が確認できるようにする
また、資料は一度整えて終わりではありません。規程の改定や商品の変更があったときに、誰が資料を差し替えるのかを決めておかないと、AIは古い情報のまま答え続けてしまいます。「資料の持ち主」を部署ごとに決め、月に1回程度、AIがうまく答えられなかった質問を振り返って資料を直す、という運用にすると、精度は使うほど上がっていきます。
7. 情報漏洩と著作権への注意:ここが一番大事です
自社専用AIを作るうえで最も注意すべきは、社内の機密情報・個人情報の取り扱いです。RAGでは社外秘の資料をAIに読ませるため、扱い方を誤ると情報が外部に出てしまうおそれがあります。
- 利用規約を確認する:入力したデータがAIの学習に使われないか、外部に保存されないかを必ず確認する
- 読ませる資料を選ぶ:契約内容・個人情報・パスワードなど、本当に必要なもの以外は渡さない
- 見られる範囲を分ける:誰がどの資料を引き出せるかを管理し、見せてはいけない情報が誰にでも返らないようにする
- 法人向けの環境を検討する:機密性が高い場合は、データを外に出さない構成や法人向けプランを検討する
- 資料に紛れた「指示」に注意する:外部から取り込んだ文書に、AIを操る悪意ある指示が埋め込まれている場合がある(プロンプトインジェクション)
また、他社が作ったWebの記事などを無断でRAGに取り込む使い方には、著作権上の懸念が指摘されています。日本新聞協会は2026年4月、AI検索サービスがRAGの技術で報道機関の記事を無断で利用しているケースがあるとして懸念を示し、記事の収集を拒否する意思表示を尊重することを法的な義務にするよう、政府に求めています。国内のルールづくりも進んでおり、政府は2025年12月に生成AIの知的財産保護と透明性に関する「プリンシプル・コード」の案を公表して意見を募り、2026年8月25日に知的財産戦略本部が正式に公表しました。社外の情報を取り込む場合は、利用が許される範囲かどうかを確認することが重要です。
8. まとめ
- RAGとは、AIが回答の前に自社の資料を「検索」し、その内容をもとに「生成」する仕組み
- 動き方は「探す→渡す→答える」の3ステップ。検索は言葉の一致ではなく「意味の近さ」で行うのが一般的
- 更新の多い社内資料には、学習し直しが不要なRAGが向いている
- 始め方は、問い合わせの多い資料1つから。プロジェクト機能やNotebookLMで手軽に体験できる
- 精度は「渡す資料の質」で決まる。話題ごとに整理し、出典を示させる
- 最も大事なのは情報漏洩の対策。利用規約の確認、資料の選別、見られる範囲の管理を徹底する
- 他社のコンテンツを取り込む場合は、著作権上、利用が許される範囲かを確認する